Donanım yazarı Ayush Pande tarafından paylaşılan testler, Mixture-of-Experts (MoE) mimarisine sahip büyük dil modellerinin (LLM), sistem RAM'i ve VRAM arasında akıllı bir paylaşımla eski ve düşük VRAM'li ekran kartlarında dahi yüksek token üretim hızlarına ulaşabildiğini ortaya koydu.
Ekim 2026 başında XDA Developers üzerinde yayımlanan donanım analizleri ve testler, Mixture-of-Experts (MoE) tabanlı büyük dil modellerinin (LLM) yerel bilgisayar ve sunucu dünyasında "ekran kartına sığma" kavramını tamamen dönüştürdüğünü ortaya koydu. Donanım yazarı Ayush Pande'nin gerçekleştirdiği pratik testlerde, 12GB VRAM kapasiteli RTX 3080 Ti ve 8GB VRAM'e sahip 10 yıllık GTX 1080 gibi eski nesil grafik kartları, sistem RAM'i ile kurulan hibrit mimari sayesinde sırasıyla 35B ve 26B parametreli devasa modelleri saniyede 24 ve 14 token gibi kararlı hızlarda çalıştırmayı başardı.
Yoğun Modellerin VRAM Çıkmazı ve MoE Mimarisinin Devrimi
Geleneksel yoğun (dense) mimariye sahip büyük dil modellerinde, modelin bütün parametrelerinin token işleme sırasında aktif olması gerekmektedir. Bu durum, grafik kartının (GPU) tüm modeli barındıracak kadar video belleğine (VRAM) sahip olmasını zorunlu kılar. Zayıf bir GPU ile model katmanlarını sistem belleğine (RAM) kaydırmak teknik olarak mümkün olsa da, PCIe veri yolu üzerinden sürekli yapılan veri alışverişi nedeniyle çıkarım (inference) hızları kabul edilemeyecek kadar düşer. Düşük hassasiyetli kuantizasyon (quantization) yöntemleri ise modellerin hesaplama kapasitesini ciddi ölçüde azaltır.
Buna karşılık Mixture-of-Experts (MoE) mimarisi, her blokta devasa ileri beslemeli ağlar bulundurmak yerine uzman adı verilen paralel ağlar barındırır. Yönlendirme (routing) mekanizması sayesinde gelen her token, tüm ağ yerine yalnızca ilgili uzman grubuna atanır; geri kalan uzmanlar ise pasif kalır. Bu benzersiz yapı, yönlendirme mekanizması, dikkat ağırlıkları, gömmeler ve aktif uzman katmanlarının VRAM'de tutulmasına, geri kalan uzman katmanlarının ise sistem RAM'inde barındırılmasına olanak tanır. Token üretim hızları bu bölüştürülmüş kurulumda büyük bir düşüş yaşamadığı için, geleneksel yoğun mimaride sürünme derecesine yavaşlayacak devasa modeller yerel sistemlerde test edilebilmektedir.
Donanım Testleri: Eski Nesil Kartlarla Devasa Modellerin Çalıştırılması
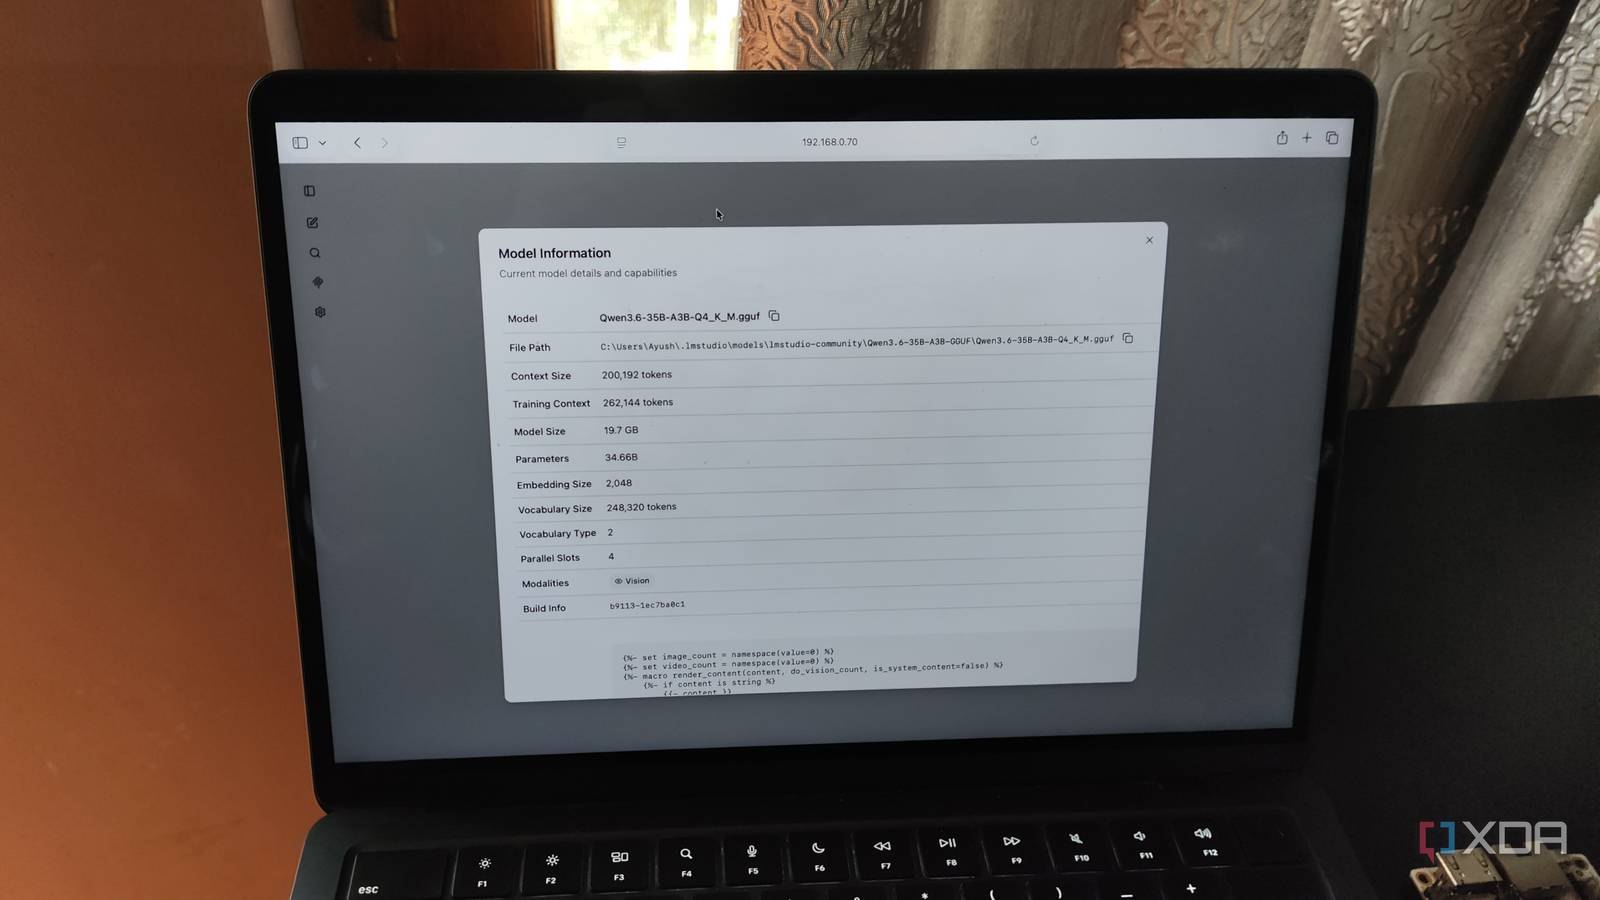
Gerçek dünya verilerine bakıldığında, 5 yıllık bir RTX 3080 Ti (12GB VRAM) ve 32GB sistem belleğine sahip bir bilgisayarda Qwen3.6-35B-A3B modeli, llama.cpp üzerindeki --no-cpu-moe bayrağı 25 katmana ayarlandığında saniyede yaklaşık 24 token hızıyla çalışabilmektedir. Bu performans, normal şartlarda pahalı ve yüksek VRAM'li profesyonel GPU'lar gerektiren 35B'lik bir model için oldukça dikkat çekicidir. Pande, bu kurulumu VS Code ortamında Copilot alternatifi olarak ve Perplexica/Vane ile proje hata ayıklamalarında aktif olarak kullanmaktadır.
Daha da eskiye gidildiğinde, kağıt üzerinde 9B sınırını aşamayan ve Tensor çekirdekleri bulunmayan 10 yıllık NVIDIA GeForce GTX 1080 (8GB VRAM), 32GB DDR4 RAM barındıran bir Proxmox düğümü içerisinde şaşırtıcı sonuçlar vermektedir. Bu Pascal dönemi kartı, Gemma-4-26B-A4B gibi büyük bir modeli saniyede yaklaşık 14 token hızla çalıştırabilmekte; bu altyapı Open Notebook, Blinko ve Paperless-GPT gibi ev laboratuvarı üretkenlik araçlarına yapay zeka özellikleri sağlamaktadır.
Doğrulanan Gerçekler
* Mimari Farkı: Yoğun LLM'ler tüm parametreleri aktif tutarken, MoE modelleri yönlendirme mekanizmasıyla token başına yalnızca belirli uzman ağlarını çalıştırır. * Bellek Paylaşımı: MoE modelleri, VRAM ve sistem RAM'i arasında yük paylaşımı yaparak hız cezası yaşamadan büyük modellerin düşük VRAM'li kartlarda çalışmasına imkan tanır. * Test Edilen Performans: 12GB VRAM'li RTX 3080 Ti ile 35B model ~24 token/sn, 8GB VRAM'li GTX 1080 ile 26B model ~14 token/sn hızlarına ulaşmıştır.
Donanım Tavsiyeleri Neden Yeniden Yazılmalı?
Geçmişte yerel LLM çalıştırmak isteyen meraklılara sunulan standart donanım tavsiyeleri, katı VRAM gereksinimleri üzerine kuruluydu. Ancak MoE modellerinin yaygınlaşması ve llama.cpp gibi açık kaynaklı araçların bellek yönetimi optimizasyonları, ev laboratuvarı kullanıcılarının maliyetli ekran kartlarına yatırım yapma zorunluluğunu hafifletmektedir. Mevcut sistem RAM'i headroom'unu verimli kullanan bu hibrit yaklaşım, bütçe dostu sistemlerle de gelişmiş yapay zeka araçlarının yerel olarak barındırılabileceğini kanıtlamaktadır.